AI駆動開発とは?定義・従来手法との違い・進め方を徹底解説
自動化
2026.04.03
2026.11.19



・最新の生成AI導入からシステム開発まで幅広く対応
・企業の生産性向上を強力にバックアップします
社内向けにRAG(検索拡張生成)を作ったものの、もっともらしい誤答(ハルシネーション)が多く、現場で使われなくなってしまった。この記事は、そうした悩みを持つ方に向けた改善手順です。
RAGは基本的な構成だけでは回答精度が実用レベルに届かないことが多く、構成要素ごとに改善手法が提案されていると、研究動向をまとめた国内の論文は述べています。この記事では、RAGの精度向上を「評価・前処理・検索・リランキング・回答制御」の5ステップに分けて、順番に何をすればよいかを解説します。最後に、自社で試行錯誤を続けるか、外部のエンジニアに任せるかの判断材料も整理します。
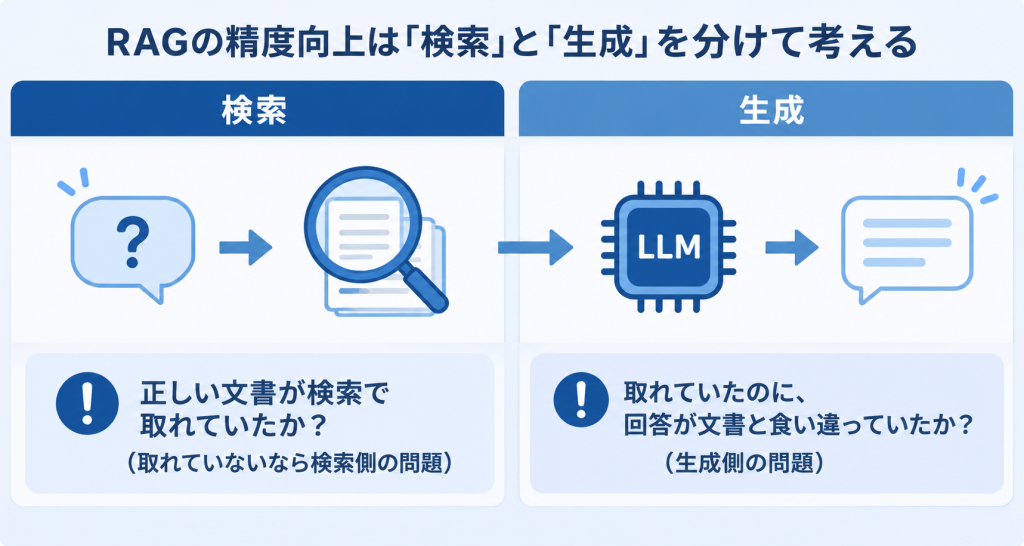
RAGは、質問に関連する文書を探し(検索)、その内容をLLMに渡して回答を作らせる(生成)仕組みです。誤答が出たとき、まず確かめるべきなのは次の2点です。
この切り分けをしないまま、プロンプトを直したりモデルを変えたりしても、どこを直すべきか分からないままになります。検索で正しい情報が取れていなければ、どれだけ優れたLLMでも正しく答えられないためです。以降の5ステップは、この切り分けを前提にしています。
最初にやるべきは、改善ではなく「測る準備」です。測れないと、直したのに良くなったのか悪くなったのか判断できません。
最初から完璧な評価セットは不要です。まず小さく作り、誤答が出るたびに質問を足していきます。以降のステップは、すべてこの評価セットで効果を確かめながら進めます。
チャンキングとは、文書をLLMが扱える長さに切り分ける作業です。切り方が悪いと、大事な文脈が途中で切れてしまいます。
研究動向を整理した国内の論文でも、チャンクを長くすると文脈は保ちやすい一方、検索の精度は短いほうが高いという報告があること、切る位置の設計をめぐって様々な議論があることが紹介されています。つまり「この長さが正解」という決まりはなく、自社の文書で比べて決めるものです。
見直すポイントは次のとおりです。
地味ですが、RAGの精度を競うコンペティションの上位解法でも、不要な文字列の除去や文書形式に合わせた分割といった地道な処理が併用されていたと、先の論文は紹介しています。LLMや検索の手法を変える前に、まず文書の状態を確認してください。
ベクトル検索(意味の近さで探す方法)は、型番・社内用語・製品名のような固有の文字列に弱いことがあります。そこで、キーワード一致で探すBM25などを組み合わせる「ハイブリッド検索」が使われます。
さらに、各チャンクに「どの文書の、どの部分の話か」を短い説明文として付け足してから登録する方法もあります。Anthropicが2024年9月に公開した「Contextual Retrieval」がその例です。同社の評価では、上位20件に正解のチャンクが入らない割合が、通常の5.7%から次のように下がったと報告されています。
| 手法 | 失敗率 | 通常比の削減 |
| 通常のRAG(ベクトル検索のみ) | 5.7% | ― |
| コンテキスト付与(埋め込み) | 3.7% | 約35% |
| コンテキスト付与(埋め込み+BM25) | 2.9% | 約49% |
| 上記+リランキング | 1.9% | 約67% |
注意点として、これはAnthropicが複数分野の評価データで測った平均値(埋め込みはGemini Text 004、上位20件で評価、リランキングはCohereを使用)で、自社の文書で同じ結果になるとは限りません。また、すでにハイブリッド検索やリランキングを導入済みなら、追加の改善幅は小さくなります。数字は「効果の方向性の目安」として読み、STEP1の評価セットで自社の効果を確かめてください。
リランキングは、最初の検索で多めに取った候補を、より精密なモデルで評価し直し、本当に関連が高い数件に絞り込む処理です。LLMに渡す情報の「質」を上げる、検索側の仕上げにあたります。
最後の点が重要です。リランキングは万能ではなく、STEP2〜3で土台を整えたうえで効く工程です。順番を飛ばさないでください。
検索が改善されたら、最後にLLMへの指示を整えます。ここでの狙いは、ハルシネーションが起きにくい「答え方のルール」を決めることです。
根拠の提示は、RAGが選ばれる主な理由のひとつとされています。ただし、必要な情報だけに絞り込むことは現実的に難しく、誤りを完全にゼロにするのも困難です。そのため、重要な業務では人が確認する運用も併せて決めておきます。
| 症状 | 疑う場所 | まず見直すステップ |
| 正しい文書が検索で出てこない | 前処理・検索 | STEP2、STEP3 |
| 型番や社内用語での質問に弱い | 検索方式 | STEP3(ハイブリッド検索) |
| 文書は出るが、順位が低い | 並び替え | STEP4 |
| 文書が出ているのに、答えが食い違う | 回答の制御 | STEP5 |
| 改善したのか悪化したのか分からない | 評価 | STEP1 |
| 古い情報・矛盾する情報で答える | データ管理 | STEP2 |

5つのステップは、どれも一度で終わる作業ではありません。評価セットの作成、文書の整理、検索方式の比較、リランキングの検証を繰り返す必要があります。研究動向をまとめた論文も、用途や文書によっては検索精度の向上の難易度が高いと述べています。
社内に生成AIの実装や活用の知見を持つ人材が少ない場合は、外部の専門人材を迎える方法もあります。
自社で続けるか迷う場合は、次の項目が当てはまるか確認してください。
当てはまる項目が多いほど、外部の知見を取り入れることを検討する材料になります。
RAGの精度向上は、次の順番で進めるのが基本です。
まず「検索」と「生成」のどちらに原因があるかを切り分け、評価セットで効果を確かめながら進めてください。自社だけで時間をかけるのが難しい場合は、外部の専門人材の知見を取り入れることも選択肢になります。


株式会社TWOSTONE&Sonsグループでは
60,000人を超える
人材にご登録いただいており、
ITコンサルタント、エンジニア、マーケターを中心に幅広いご支援が可能です。
豊富な人材データベースと創業から培ってきた豊富な実績で貴社のIT/DX関連の課題を解決いたします。
幅広い支援が可能ですので、
ぜひお気軽にご相談ください!